PostgreSQL'de Tenant Partition'larını İlk İstekte Oluşturmak
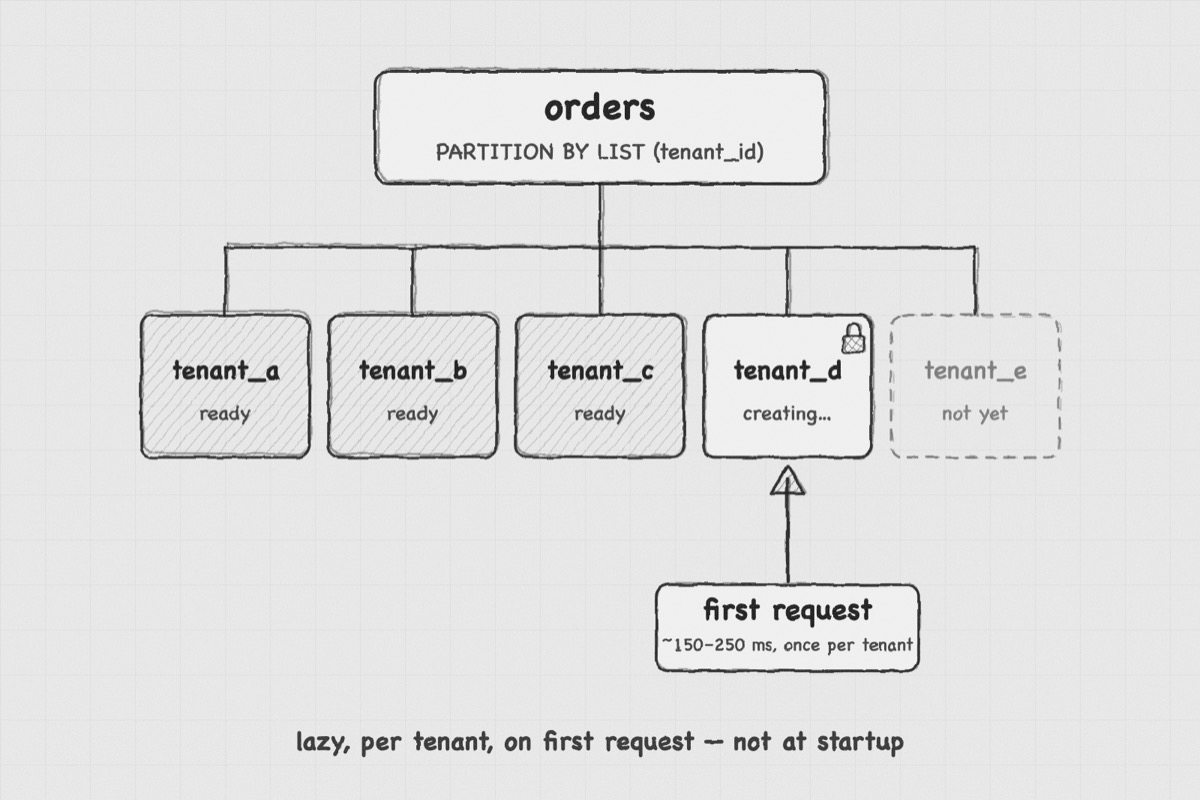
Multi-tenant bir sistemde birden fazla tenant aynı PostgreSQL schema'sını paylaşabilir. Bu veriyi ayırmanın yaygın yollarından biri, paylaşılan tabloları tenant_id alanına göre PARTITION BY LIST (tenant_id) ile partition etmektir. Böylece her tenant'ın satırları aynı parent table altında ayrı bir partition'da tutulur. Bir sorgu tenant_id ile filtrelendiğinde PostgreSQL diğer partition'lara bakmadan yalnızca ilgili partition'ı okuyabilir. Bu da hem izolasyon hem de performans açısından fayda sağlar.
Asıl soru şu: bu partition'ları ne zaman oluşturacağız? Startup sırasında oluşturmak ilk bakışta basit görünür. Ama her yeniden başlatmada ek iş çıkarır ve tenant sayısı arttıkça yavaşlar. Bu yüzden partition'ları startup'ta değil, ilk istekte oluşturuyoruz.
Veri modeli
Önce veri modeline bakalım. Tabloyu tenant bazında partition ediyoruz:
CREATE TABLE orders (
    id         uuid not null,
    tenant_id  uuid not null,
    -- ... columns ...
    primary key (id, tenant_id)
) PARTITION BY LIST (tenant_id);

CREATE TABLE orders_default PARTITION OF orders DEFAULT;
tenant_id, primary key'in bir parçası olmak zorundadır. PostgreSQL, partition key'in her unique constraint içinde yer almasını ister. Bir tenant partition'ı da tek bir SQL ifadesiyle eklenebilir:
CREATE TABLE orders_t_d4e5f6a7 PARTITION OF orders
    FOR VALUES IN ('d4e5f6a7-...-...');
Geriye şu soru kalır: Bu ifade ne zaman çalışmalı?
Startup provisioning neden ölçeklenmez?
Önce startup-first yaklaşımına bakalım. Servis açılırken aktif tenant'ları listeler, hedef cluster'da her tenant için partition'ların zaten var olup olmadığını kontrol eder ve eksik olanları trafik almadan önce oluşturur. Anlaması kolaydır. İlk istek geldiğinde schema hazırdır.
Problem şu ki her instance startup'ta tenant listesini dolaşmak, hedef cluster'ında hangi tenant'ların zaten provision edildiğini kontrol etmek ve eksik olanları oluşturmadan trafik alamaz. Varlık kontrolü ucuzdur, ama yine de her tenant için çalışmak zorundadır. Asıl pahalı kısım eksik partition'ları oluşturmaktır. Eksik tenant sayısı arttıkça bu maliyet hızla birikir.
Bu yaklaşım autoscaling ile iyi çalışmaz. Kubernetes benzeri bir ortamda pod'un hızlıca Ready olması ve hemen trafik almaya başlaması gerekir. Dakikalarca tenant kontrolü yapıp DDL çalıştıran bir pod, scale-out'u geciktirir, toparlanmayı yavaşlatır ve deployment'ları uzatır. Çoğu sistemin burada ihtiyacı olan şey, hızlı ve ucuz startup'tır.
İlk istekte provisioning
Diğer seçenek, bekleyip tenant partition'larını ilk istekte oluşturmaktır.
Bunun için uygun yer, tenant çözümlendikten sonra ve istek handler'a gitmeden önce request pipeline'dır:
public async Task InvokeAsync(HttpContext context, ITenantPartitionProvisioner provisioner)
{
    var tenant = context.GetTenant();

    // Hızlı yol: bu process bu tenant'ı zaten provision etti mi?
    if (tenant is not null && !_provisioningCache.Contains(tenant.Id))
    {
        try
        {
            await provisioner.EnsureProvisionedAsync(tenant.Id, tenant.ConnectionString);
            _provisioningCache.Add(tenant.Id);
        }
        catch (Exception ex)
        {
            // Fail closed — aşağıda.
            _logger.LogError(ex, "Partition provisioning failed for {TenantId}", tenant.Id);
            context.Response.StatusCode = StatusCodes.Status503ServiceUnavailable;
            return;
        }
    }

    await _next(context);
}
Bu yaklaşım startup'ı hızlı tutar ve autoscaling'in düzgün çalışmasını sağlar. Pod'lar hızlıca Ready olur, deployment'lardan sonra sistem daha çabuk toparlanır ve iş yükü tenant'lar sistemi kullandıkça zamana yayılır. Bir instance bu maliyeti yalnızca gerçekten hizmet verdiği tenant'lar için ve yalnızca onların ilk isteğinde öder. Bizim ortamımızda bu ilk istek maliyeti yaklaşık 150-250 ms'dir.
Şimdi bunun güvenli kalmasını sağlayan üç parçaya bakalım: provisioning kontrolünü cache'lemek, concurrency'yi yönetmek ve hata durumunda fail closed davranmak.
Provisioning kontrolünü cache'lemek
Provisioning path her istekte veritabanına gitmemelidir. Her istekte catalog sorgusu çalıştırmak, tek seferlik startup maliyetini kalıcı bir request maliyetine çevirir. Bu iyi bir trade-off değildir.
Bu yüzden request pipeline provisioning durumunu process içi bir cache'te tutar. Cache hit olduğunda middleware provisioning adımını atlar. Cache miss olduğunda EnsureProvisionedAsync çağrılır. O da bir şey oluşturmadan önce veritabanını yeniden kontrol eder.
Cache şu kadar basit olabilir:
// Process başına tek örnek. Her tenant için uygulanan provisioning version'ını tutar.
private readonly ConcurrentDictionary<Guid, int> _provisioned = new();

public bool Contains(Guid tenantId) =>
    _provisioned.TryGetValue(tenantId, out var v) && v == ProvisioningVersion.Current;

public void Add(Guid tenantId) => _provisioned[tenantId] = ProvisioningVersion.Current;
Cache key sadece tenant id değildir. Bir de provisioning version içerir. ProvisioningVersion.Current, partition edilen tabloların kümesi değiştiğinde artar.
Bir tenant eski bir version altında kayıtlıysa, yeni version için henüz provision edilmemiş kabul edilir. Bir sonraki isteğinde provisioning yeniden çalışır ve yalnızca eksik partition'lar oluşturulur. Bu version olmasa, schema değişse bile cache tenant'ın zaten provision edildiğini söylemeye devam edebilir. Bu da yeni eklenen tablonun mevcut tenant'lar için partition'ının oluşturulmasını engeller.
Burada Redis gibi paylaşılan bir cache gerekmez. Provisioning birden fazla kez çalıştırılmaya güvenlidir. Bir process bir tenant'ı henüz kaydetmediyse, yük altında birkaç ek existence check yapabilir. Ama aynı partition'ı güvensiz biçimde iki kez oluşturmaya çalışmaz. Process içi cache dış koordinasyonu ortadan kaldırır ve tasarımı daha basit tutar.
Concurrency'yi yönetmek
Bir sonraki problem, genelde ancak yük altında gördüğünüz yarış durumudur: aynı tenant için iki ilk istek aynı anda gelebilir. İki istek birkaç milisaniye arayla gelirse, ikisi de cache miss olur, ikisi de EnsureProvisionedAsync çağırır ve ikisi de partition oluşturmaya çalışır. Biri başarılı olurken diğeri hata alabilir. Provisioning serialize edilmez ve tek transaction içinde tutulmazsa, tenant birden fazla tablo için yarım kurulmuş halde de kalabilir.
Bunu tenant bazında alınan PostgreSQL transaction-scoped advisory lock çözer:
public async Task EnsureProvisionedAsync(Guid tenantId, string connectionString)
{
    await using var conn = new NpgsqlConnection(connectionString);
    await conn.OpenAsync();
    await using var tx = await conn.BeginTransactionAsync();

    // Bu tenant için provisioning işlemini serialize et.
    var (ns, key) = PartitionLockKey(tenantId);
    await using (var lockCmd = new NpgsqlCommand(
        "SELECT pg_advisory_xact_lock(@ns, @key)", conn, tx))
    {
        lockCmd.Parameters.AddWithValue("ns", ns);
        lockCmd.Parameters.AddWithValue("key", key);
        await lockCmd.ExecuteNonQueryAsync();
    }

    // Lock içindeyken yeniden kontrol et: önceki istek işi bitirdi mi?
    if (await PartitionsExistAsync(conn, tx, tenantId))
    {
        await tx.CommitAsync(); // lock'u temiz bir commit ile bırak
        return;
    }

    await CreateAllPartitionsAsync(conn, tx, tenantId);

    await tx.CommitAsync(); // transaction biter, advisory lock bırakılır
}
Helper, tenantId değerinden kararlı bir advisory-lock key üretir. Partition provisioning için sabit bir namespace ile tenant id'nin kararlı hash'ini birleştirir:
// Bir tenant için kararlı advisory-lock key.
// Partition provisioning için sabit namespace + tenant id'nin hash'i
static (int ns, int key) PartitionLockKey(Guid tenantId)
{
    const int ns = 0x50_41_52_54; // "PART" ifadesinin ASCII karşılığı
    Span<byte> bytes = stackalloc byte[16];
    tenantId.TryWriteBytes(bytes);
    int key = unchecked((int)Crc32.HashToUInt32(bytes));
    return (ns, key);
}
Bu hash güvenlik için kullanılmaz. Sadece tenant id'yi tutarlı bir lock key'e eşlemesi yeterlidir.
Burada dikkat edilmesi gereken birkaç nokta var:
- Advisory lock tenant bazındadır. Aynı tenant için iki process'in aynı anda provisioning yapmasını engeller.
- Lock transaction-scoped'tur.
pg_advisory_xact_lockkullanıldığı için istek hata verirse PostgreSQL lock'u otomatik bırakır. - Transaction küçük kalmalıdır. Partition oluşturmak parent partitioned table üzerinde kısa süreli bir lock alır. Bu yüzden bu path yalnızca eksik işi yapmalı ve hemen commit etmelidir.
- Kod lock alındıktan sonra tekrar kontrol eder. İlk istek partition'ları oluşturur. Arkadaki istekler bekler, yeniden kontrol eder ve işin zaten yapıldığını görür.
Bu yol yalnızca cache miss durumunda çalışır. Cache ısındıktan sonra bu durum nadirleşir.
Fail closed
Provisioning hata verirse istek durmalıdır. Tenant'ın storage'ı henüz hazır değilse uygulama devam edip veriyi yanlış yere yazma riski almamalıdır. Bizim durumda middleware 503 Service Unavailable döner. Bu, daha sonra yeniden denemek için açık bir sinyaldir ve istek başarılı olmuş gibi davranmaktan çok daha güvenlidir.
DEFAULT partition'a da aynı gözle bakılmalıdır. Default partition içinde veri görmek, normal provisioning path'ini atlayan bir write olduğu anlamına gelir ve incelenmelidir. Eğer DEFAULT partition yoksa, aynı write yüksek sesle fail olur. DEFAULT partition varsa write sessizce yakalanır. Bu yüzden monitoring şarttır.
Maliyet profili
Lazy provisioning maliyeti yok etmez. Sadece yerini değiştirir. Aşağıdaki sayılar bizim ortamımızdan geliyor. Tam değerler değişebilir, ama genel şekil çoğu zaman aynı kalır:
| Adım | Ne zaman | Maliyet |
|---|---|---|
| In-memory hit | Her process için, tenant'ın ilk isteğinden sonraki tüm isteklerde | ihmal edilebilir |
| Catalog yeniden kontrolü | Tenant başına, process'teki ilk istek (cache miss, ama zaten provision edilmiş) | birkaç ms |
| Tam provisioning | Bir tenant için ilk istek, ya da version arttıktan sonraki ilk istek | ~150-250 ms |
Ödediğiniz bedel basittir: tenant başına process'teki bir istek daha yavaş olur. Bizim ortamımızda bu ek gecikme yaklaşık 150-250 ms'dir. Karşılığında pod'lar hızlıca Ready olur, deployment'lardan sonra sistem daha hızlı toparlanır ve provisioning işi startup'ta tek seferde ödenmek yerine zamana yayılır. Tenant'ların dinamik oluştuğu bir platform için bu trade-off çoğu zaman değerlidir.
Startup provisioning ne zaman doğru seçimdir?
Küçük ve sabit bir tenant kümesi varsa - örneğin elle eklenen birkaç düzine tenant - startup sırasında provisioning daha iyi seçimdir. Partition'ları startup kodunda ya da bir migration'da oluşturup devam edersiniz. Bu durumda lazy provisioning ekstra karmaşıklığa değmez.
Kararı belirleyen asıl şey tenant sayısı ve sisteme nasıl geldikleridir. Tenant sayısı fazla ve tenant'lar dinamik oluşuyorsa lazy provisioning değer kazanır. Startup provisioning'in zorlanmaya başladığı yer de tam olarak burasıdır.
Schema değişiklikleri sıklaştığında bu fark daha da belirginleşir. Startup provisioning tarafında her yeni partitioned table, bir sonraki boot'ta mevcut tenant'ların yeniden kontrol edilmesi ve gerekirse yeniden provision edilmesi demektir. Lazy yaklaşımda ise provisioning version artar ve her tenant bir sonraki isteğinde eksik kısmı tamamlar.
Buradaki daha geniş ders sadece PostgreSQL ile ilgili değildir. "Tüm işi en başta yapmak" ile "işi gerektiğinde yapmak" gerçekten iki ayrı seçimdir. Daha temiz görünen seçenek her zaman ölçekte daha iyi çalışan seçenek değildir. Asıl mesele, sizin sisteminiz için hangi özelliğin daha önemli olduğunu bulmaktır. Birkaç bin tenant seviyesinde bu özellik çoğu zaman hızlı startup olur.
Bu makaledeki örnek kod parçaları GitHub reposunda yer alıyor.
English version: Read in English
İlgili Yazılar
MediatR Pipeline Behavior'ları ile Fail-Closed Yetkilendirme
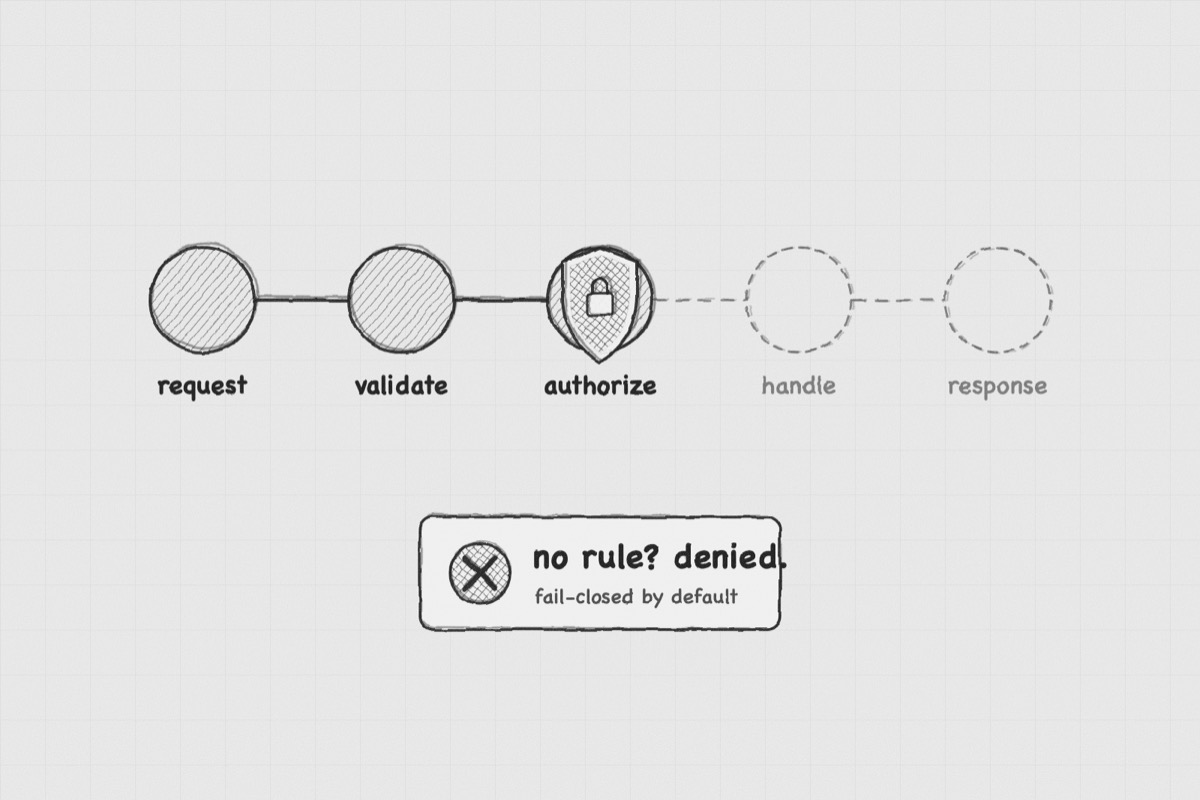
Erişim ya da izin kuralı tanımlı olmayan bir isteğin neden reddedildiğini anlatıyor.
PostgreSQL'de Tenant Partition'larını İlk İstekte Oluşturmak
Tenant partition'larının neden uygulama açılışında değil, ilk istekte oluşturulduğunu anlatıyor.
Redis'te Version Counter ile Cache Invalidation
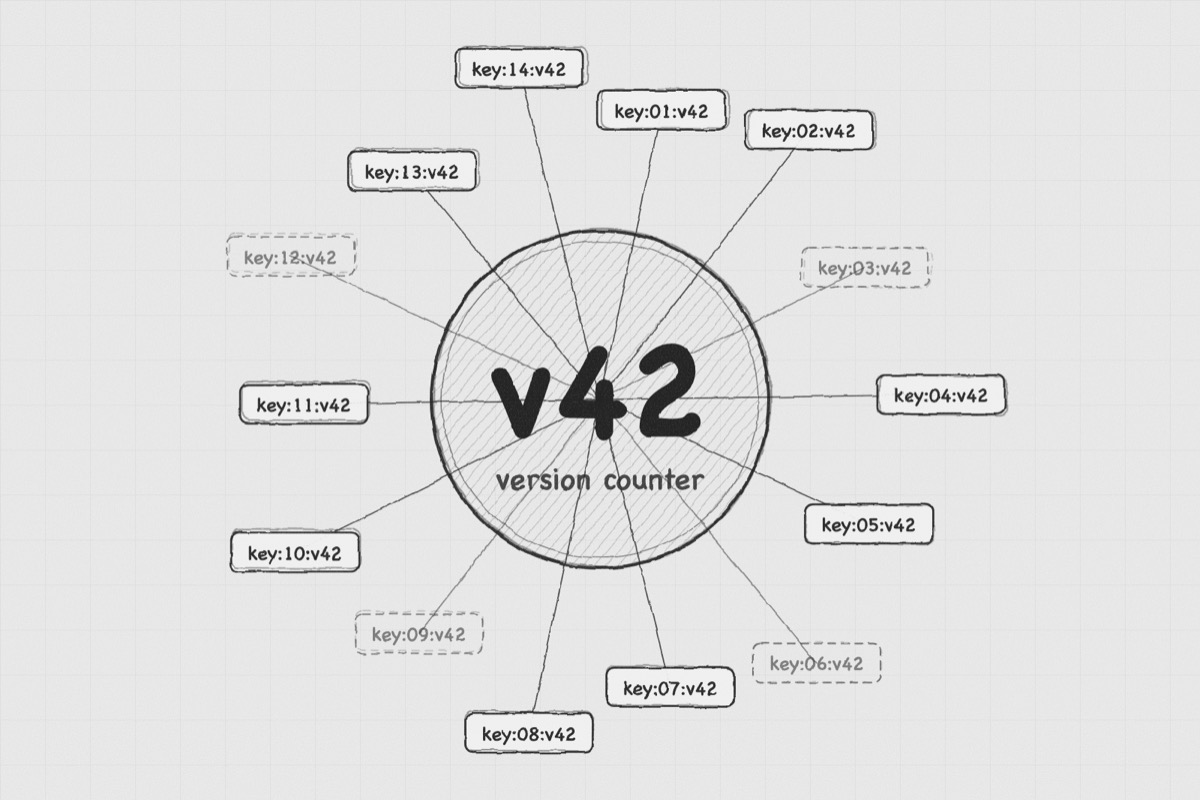
Cache'i key tarayarak değil, bir sayaç artırarak neden geçersiz kıldığımızı anlatıyor.
