Redis'te Version Counter ile Cache Invalidation
Redis'te bir query sonucunu cache'lemek kolaydır. Query'yi sararsınız, sonucu bir key altında tutarsınız, bir TTL verirsiniz ve okumalar hızlanır.
Zor kısım veri değiştiğinde başlar. Eski entry'ler nasıl ortadan kalkar? Basit cevap, ilgili key'leri bulup silmektir. Bu küçük ölçekte çalışır, ama iyi ölçeklenmez. Üstelik maliyeti değişikliği yapan write'a değil, aynı Redis instance'ını kullanan diğer client'lara yükler. Şimdi neden key taramak yerine bir version counter artırdığımıza bakalım. Ayrıca bunu pratikte işe yarar hale getiren parçaları da göreceğiz: scoping, stampede control ve cache'i veri sızıntısına çevirebilecek tek setup için boot-time check.
Pattern ile silmek neden ölçeklenmez?
Önce en doğrudan yaklaşıma bakalım. Diyelim ki organization type kayıtları orgtypes:* gibi bir prefix ile cache'leniyor. Birisi bir org type'i değiştirdiğinde, bu listenin tüm cache'lenmiş sürümlerinin gitmesi gerekir. Doğrudan çözüm, bu key'leri pattern ile bulup silmektir:
var keys = server.Keys(pattern: "orgtypes:*");
foreach (var key in keys)
    await db.KeyDeleteAsync(key);
Bu, keyspace küçükken development ortamında gayet normal görünür. Production'da ise trade-off değişir:
KEYStüm keyspace üzerinde O(N)'dir ve Redis command'ları tek thread'de çalıştırır. Redis milyonlarca key içinde birkaç yüz taneyi ararken diğer client'lara hizmet vermez.SCANdaha iyidir, ama ölçeklenme problemini ortadan kaldırmaz. İşi tek uzun blok yerine birden fazla çağrıda yapar. Ama hâlâ O(N)'dir, tarama sırasında değişen key'leri kaçırabilir ya da tekrar görebilir ve bulunan her key yine tek tek silinmelidir.- Redis Cluster ile temiz oturmaz.
KEYSveSCANnode bazında çalışır. Bu yüzden sharded bir keyspace'te pattern taraması yapmak için her node'a gidip sonuçları birleştirmeniz gerekir. - Yöntem naming rule'larına bağlıdır. Her key pattern'in yakalayacağı naming rule'a uymak zorundadır. Uymayan bir key stale kalır ve kimse onu bulamaz.
Daha derin problem şu fikirdir: Bir entry'yi invalidate etmek için onu bulup silmek zorundasınız.
Stale entry'leri erişilemez yapmak
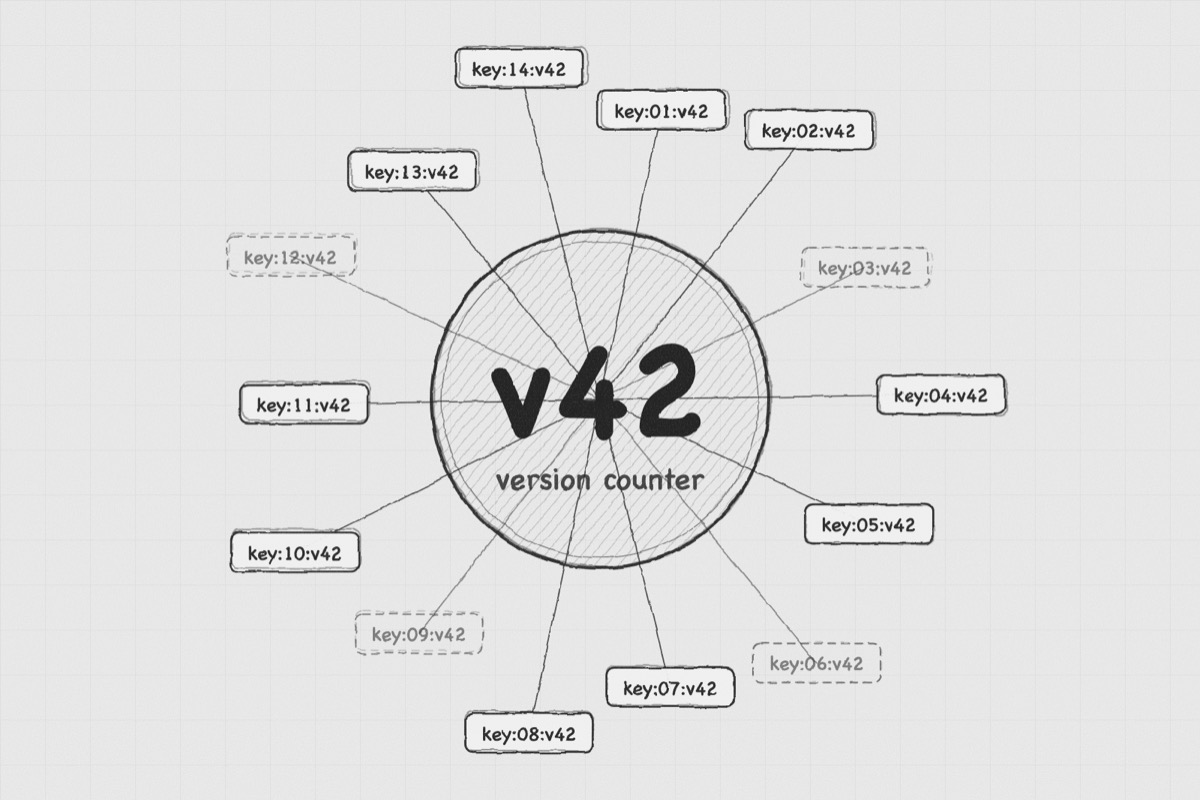
Bir entry'nin invalid olması için silinmesi gerekmez. Sadece artık erişilemez olması yeterlidir. Yeni okumalar ona giden key'i üretmeyi bırakırsa, eski entry kullanılmayan veri haline gelir. Redis de daha sonra TTL dolduğunda bunu temizler.
Version counter'ın fikri tam olarak budur. Version key'in içine girer ve güncel version'ı bir counter tutar:
key      =  q:{name}:v{version}:{argsHash}
counter  =  ver:{name}            ->  a Redis integer; a missing counter reads as 0
- Okumada: güncel version'ı alırsınız, key'i kurarsınız ve lookup yaparsınız. Miss olursa sonucu hesaplar ve TTL ile yazarsınız.
- Invalidate etmek için:
INCR ver:{name}.
Bu artırma hiçbir cache entry'sine dokunmaz. Bundan sonraki okumalar v{version+1} ile key üretir, miss olur ve kaynaktan yeniden doldurur. Eski generation artık yeni okumalar için erişilemez hale gelir ve kendi TTL'i dolunca silinir. Böylece invalidation, O(N) keyspace taraması yerine tek bir O(1) increment olur. Redis Cluster tarafında da daha doğal oturur, çünkü invalidation bir pattern taraması yapmak yerine tek bir counter key'i günceller.
Okuma tarafı
Bir .NET servisinde bunun doğal yeri MediatR pipeline behavior'dır. Böylece cache mantığı handler'ların içine tek tek yazılmaz; request üzerinde deklare edilir:
public async Task<TResponse> Handle(
    TRequest request, RequestHandlerDelegate<TResponse> next, CancellationToken ct)
{
    var spec = CacheAttribute.For(request);   // { Name, Scope } or null
    if (spec is null)
        return await next();                   // not cached — pass through

    var version = await _redis.GetCounterAsync(VersionKey(spec));  // 0 when absent
    var key = $"q:{spec.Name}:v{version}:{Hash(request)}{ScopeSuffix(spec)}";

    if (await _redis.GetAsync<TResponse>(key) is { } hit)
        return hit;

    var result = await next();
    await _redis.SetAsync(key, result, ttl: TimeSpan.FromMinutes(30));
    return result;
}

static string VersionKey(CacheSpec s) => $"ver:{s.Name}{ScopeSuffix(s)}";

static string Hash(object request)
{
    var json  = JsonSerializer.Serialize(request);
    var bytes = SHA256.HashData(Encoding.UTF8.GetBytes(json));
    return Convert.ToHexString(bytes)[..16].ToLowerInvariant();  // arguments fingerprint
}
Burada iki küçük ayrıntı önemlidir.
İlki, eksik counter 0 gibi okunur. Yani ayrı bir setup adımı yoktur. Yeni bir cache name anında çalışır ve ilk INCR onu 1'e çıkarır.
İkincisi, arguments hash her farklı parametre set'i için ayrı bir entry üretir. Tüm bu key'leri tek tek sizin yönetmeniz gerekmez.
Bir küçük not daha ekleyelim. On altı hex karakter 64 bit demektir. Bu da teoride iki farklı request'in aynı fingerprint'i üretip aynı entry'yi paylaşabileceği anlamına gelir. Bu risk çok büyük ya da kullanıcı kontrollü parametre alanı olan bir cache için önemliyse, digest'in daha büyük bir kısmını tutun.
Invalidation tarafı
Query'ler neyi cache'lediğini deklare eder. Command'lar da aynı şekilde neyi invalidate ettiğini deklare edebilir. Command başarılı olduktan sonra behavior doğru counter'ları artırır:
// başarılı bir command'dan sonra invalidate ettiği her cache name için version artır
var scopeSuffix = ScopeSuffixFor(request);
foreach (var name in ResolveNames(InvalidatesAttribute.For(request)))
    await _redis.IncrementAsync($"ver:{name}{scopeSuffix}");   // O(1)
[Cache("orgtypes.list", CacheScope.Organization)]
public record ListOrgTypes(Guid OrgId) : IRequest<IReadOnlyList<OrgType>>;

[Invalidates("orgtypes")]
public record CreateOrgType(Guid OrgId, string Name) : IRequest<Result>;
Buradaki kritik nokta şudur: query ile command aynı version key'i üretmelidir: ver:{name}{scope}.
Bu gözden kolayca kaçabilir, çünkü iki taraf da tek başına doğru görünebilir.
Yukarıdaki örnekte bunu iki küçük parça sağlar:
- Name resolution.
orgtypesson cache key değildir; bir grup adıdır.ResolveNamesbunuorgtypes.listya daorgtypes.getgibi gerçek cache name'lere açar. Bu adım olmazsa commandver:orgtypesartırır ve hiçbir okuma bu counter'a bakmaz. - Context'ten scope üretmek. Command kendi context'ini kullanarak query'nin kullandığı aynı scope suffix'i üretir. Böylece org A için gelen write sadece org A'nın counter'ını artırır, herkesinkini değil.
Buradaki hata sinsi olabilir: command gerçek bir Redis key'i artırır, ama query'nin baktığı key'i artırmaz.
Invalidation sadece başarı durumunda çalışır. Hata veren ya da failure döndüren bir command, counter'ları ve cache'i olduğu gibi bırakır. Yarım kalmış bir write, hâlâ geçerli olan cache'i temizlememelidir.
Invalidation'ı scope etmek
Cache name başına tek bir counter çok kabadır. Tek bir organization'in verisi değiştiğinde tüm tenant'lar için cache'i patlatmak istemezsiniz.
Çözüm, counter'i scope etmektir. Her cache'e bir scope verirsiniz, bu scope'u hem entry key'ine hem de version key'ine eklersiniz. Böylece her dilim kendi counter'ına sahip olur:
static string ScopeSuffix(CacheSpec s) => s.Scope switch
{
    CacheScope.All          => "",
    CacheScope.Organization => $":org:{s.OrgId}",
    CacheScope.Unit         => $":unit:{s.UnitId}",
    CacheScope.User         => $":user:{s.UserId}",
    _ => throw new UnreachableException()
};
Örneğin cache name orgtypes.list ise, ver:orgtypes.list:org:{A} ile ver:orgtypes.list:org:{B} iki farklı counter olur. Org A invalidate edildiğinde sadece A'nın counter'ı artar. Org B'nin cache'i sıcak kalır.
Scope'lar bir hiyerarşi de kurabilir: All, Organization, Unit, User. Eğer dependency'leri deklare ederseniz geniş bir invalidation, altındaki her şeye yayılabilir. Ama bu ancak cache başta doğru scope ile deklare edilirse çalışır. Scope yanlışsa, izolasyon da yanlıştır. Sonraki bölüm bu hatayı anlatır.
Stampede'i önlemek
Bir sonraki problem genelde ancak yük altında görünür: recompute stampede. Sıcak bir cache invalidate edilir, çok sayıda request neredeyse aynı anda yeni version'ı okur, hepsi miss olur ve hepsi alttaki query'yi aynı anda çalıştırır.
Çözüm single-flight'tir: her key için sadece bir request yeniden hesaplar, diğerleri bekler.
var gate = _locks.GetOrAdd(key, _ => new SemaphoreSlim(1, 1));
await gate.WaitAsync(ct);
try
{
    if (await _redis.GetAsync<TResponse>(key) is { } hit)   // double-check inside the lock
        return hit;

    var result = await next();
    await _redis.SetAsync(key, result, ttl);
    return result;
}
finally { gate.Release(); }
Lock içindeki ikinci cache check bu yapıyı işe yarar hale getirir. İlk request sonucu hesaplar ve yazar. Arkadaki request'ler uyandığında taze entry'yi görür ve tekrar kaynağa gitmeden döner.
Bu lock key bazındadır ve process-local'dir. Yani tek bir instance içindeki herd'i daraltır, ama tüm filoyu koordine etmez. Aynı hot key için on instance aynı anda miss olursa, hâlâ on farklı recompute görebilirsiniz. Bu genelde kabul edilebilir bir trade-off'tur. Çünkü alternatif, her cache miss'in önüne distributed lock koymaktır.
Lock map'inin bir de memory maliyeti vardır. _locks, bir key'i ilk gördüğü anda bir SemaphoreSlim alır ve sonra bunu bırakmaz. Bu yüzden farklı key sayısı çok olan bir cache bu map'i sürekli büyütebilir. Bu önemliyse sabit sayıda lock slot'u kullanabilir ve her key'i bir slot'a hash'leyebilirsiniz. Bu biraz ek bekleme yaratır, ama memory artık key sayısı ile birlikte büyümez.
Shared cache üzerinde per-user veri yakalamak
Bir yanlış konfigürasyon yalnızca normal bir bug değildir. Hem correctness bug'idir, hem de security bug'idir. Bu yüzden bunu sonradan değil, startup'ta yakalamak daha iyidir.
Şöyle bir query düşünün: CacheScope.All ile cache'lenmiş olsun, ama handler current user'i kullansın:
[Cache("my.dashboard", CacheScope.All)]          // one shared entry for everyone
public record GetMyDashboard() : IRequest<Dashboard>;

// handler:
var me = _currentUser.Id;                          // ...but the result is per-user
return await BuildDashboardFor(me);
User A dashboard'ini yükler ve sonuç tek bir shared key altına cache'lenir. User B kendi dashboard'ini yüklediğinde aynı key'e çarpar ve User A'nın dashboard'ini görür. Cache "shared" diyor, ama handler gerçekte current user'a bağlıdır.
Bu bug testleri kolayca geçer, çünkü tek kullanıcılı testler bunu göstermez. Genelde ancak birden fazla kullanıcı ve sıcak cache ile ortaya çıkar.
Bunu sadece code review'a bırakmamak gerekir. Startup'ta da yakalamak gerekir. Boot sırasında tüm cached query'leri gezip, CacheScope.All kullanan ama handler'i current user'a bağlı olanları fail ettirebilirsiniz:
foreach (var q in CachedQueries(scope: CacheScope.All))
{
    if (q.HasAttribute<CacheScopeVerified>()) continue;     // explicit, reviewed opt-out
    if (HandlerDependsOn<ICurrentUser>(q))
        errors.Add($"{q.Name}: cached at CacheScope.All but the handler reads ICurrentUser " +
                   "— per-user data in a shared key.");
}
if (errors.Count > 0)
    throw new CacheConfigurationException(errors);          // fail closed, at boot
Bu kontrol faydalı bir guardrail'dir, ama proof değildir. Yukarıdaki doğrudan pattern'i yakalamakta iyidir. Ama handler current user'a helper method, service call ya da composed expression üzerinden ulaşıyorsa scan bunu kaçırabilir. Bazen de güvenli kodu yanlış pozitif olarak flag'leyebilir. Bu yüzden opt-out attribute vardır. Bunu her şeyi kanıtlayan bir garanti gibi değil, yaygın hatayı erkenden görünür yapan bir guardrail gibi kullanın.
Maliyet profili
Version-counter invalidation maliyeti yok etmez. Sadece yerini değiştirir. Trade-off'lar nettir:
- Her cached request için bir counter read. Her okuma, değerden önce version'ı da alır. Bu da bir ekstra round trip demektir. Bu iki çağrının pipeline edilmesi mümkündür. Ama Redis Cluster'da iki key aynı slot'a düşmelidir; bunun için hash tag gerekebilir.
- Eski generation'lar TTL'e kadar kalır.
INCRsonrasında eski generation, TTL dolana kadar Redis'te kalır. Sıklıkla invalidate edilen bir cache bir süre birden fazla eski generation tutabilir. - Kısa bir stale window.
INCR'den hemen önce counter'i okumuş bir read, hâlâ eski generation'i populate edebilir. Bu çoğu cache için kabul edilebilir. Eğer sisteminiz bir write'i bir sonraki read'de kesin göstermek zorundaysa, bu garanti cache'in işi olmamalıdır.
Karşılığında şunu kazanırsınız: invalidation artık O(N), cluster-friendly olmayan bir sweep değil; tek bir atomic increment olur. KEYS kullanımının acıtmaya başladığı büyüklükteki her cache için bu trade-off genelde mantıklıdır.
Pattern ile silmek ne zaman doğru seçimdir?
Cache keyspace küçükse ve invalidation nadirse, SCAN ile bulup silmek gayet iyidir. Var olmayan bir problem için versioning scheme kurmaya gerek yoktur. Ayrıca "invalidate" gerçekten "bu veri hemen ve kanıtlanabilir şekilde gitmeli" demekse — örneğin GDPR kapsamında bir silme talebinden sonra — version counter doğru araç değildir. Eski entry'ler TTL dolana kadar Redis'te kalır. Böyle bir durumda açık bir delete gerekir.
Çoğu gerçek durumda ise — çok sayıda cached query varyantı, sık invalidation, büyüyen bir keyspace ve zamanla cluster — counter değerini gösterir. Ölçekte en kötü davranan operasyonu, yani keyspace scan'i, tek bir atomic increment ile değiştirir. Ayrıca invalidation'i de key prefix'lerinden olay anında tahmin edilen bir şey olmaktan çıkarıp, baştan deklare edilen bir şeye dönüştürür.
Yazının merkezindeki trade-off budur: TTL'i bekleyen sınırlı miktarda eski veri, buna karşılık artık diğer herkes için latency problemi olmayan bir invalidation.
Bu makaledeki örnek kod parçaları GitHub reposunda yer alıyor.
English version: Read in English
İlgili Yazılar
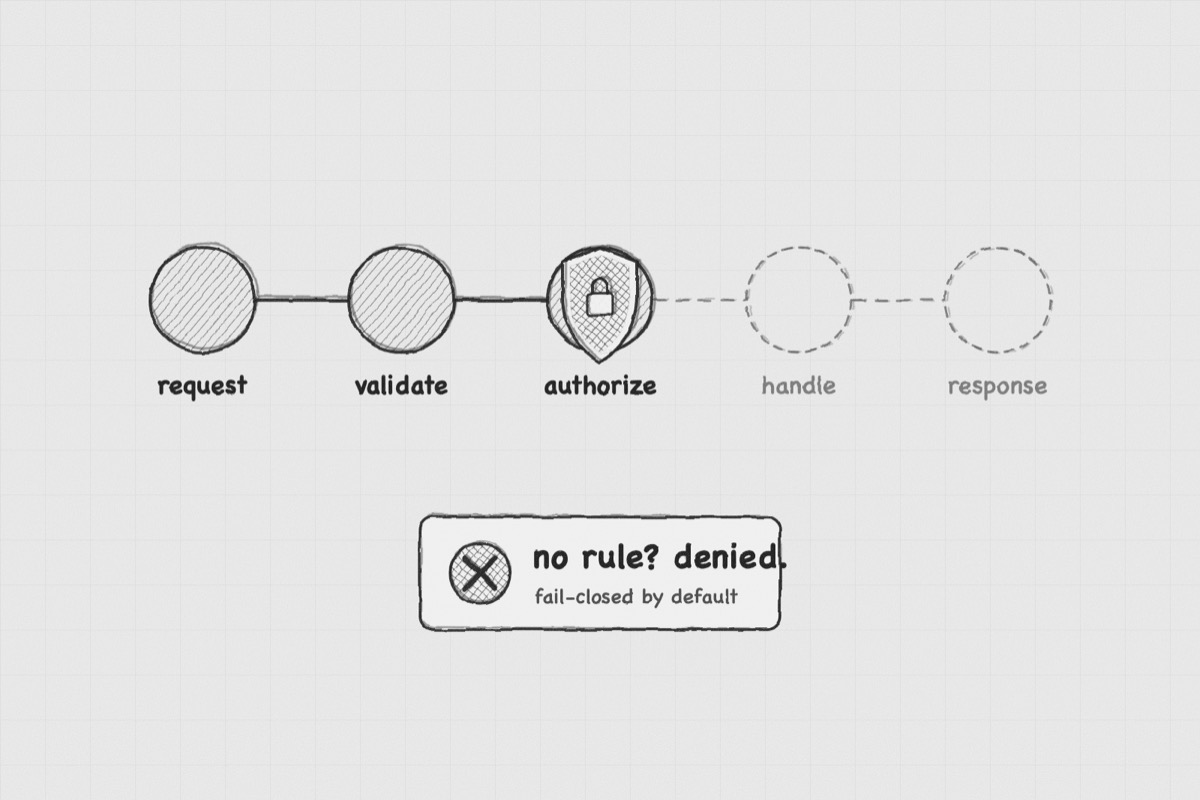
MediatR Pipeline Behavior'ları ile Fail-Closed Yetkilendirme
Erişim ya da izin kuralı tanımlı olmayan bir isteğin neden reddedildiğini anlatıyor.
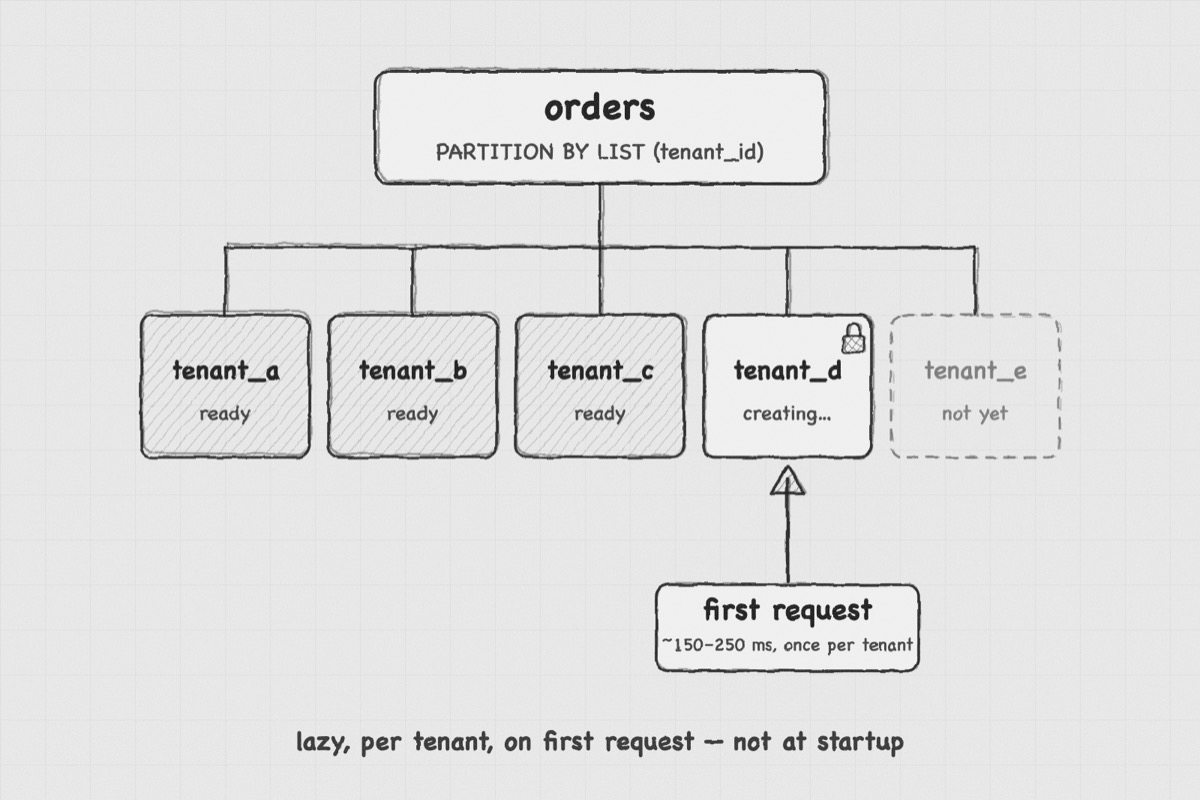
PostgreSQL'de Tenant Partition'larını İlk İstekte Oluşturmak
Tenant partition'larının neden uygulama açılışında değil, ilk istekte oluşturulduğunu anlatıyor.
Redis'te Version Counter ile Cache Invalidation
Cache'i key tarayarak değil, bir sayaç artırarak neden geçersiz kıldığımızı anlatıyor.
